A Fix for Softmax and Cross-Entropy
JAX、PyTorch、TensorFlow 里 softmax、log-softmax 和交叉熵的标准写法在浮点下有两个 bug。模型对正确类别非常自信时,目标 logit 的梯度被舍成 0,而其他梯度没有,梯度之和不再为 0;蒸馏时学生逼近老师,梯度本该趋于 0,却停在一个非零的噪声底上。作者用 Adam 的归一化解释了这两个 bug 如何被放大成训练中的 loss 尖峰和参数漂移,并给出只改几行代码的修复。
fp32 共 32 位,即 4 字节:1 位符号 S、8 位指数、23 位尾数。下面是 1.0 的存法(十六进制 0x3F800000):
- 数值 = (−1)S × 1.尾数 × 2指数 − 127。1.0 的 S = 0,指数 = 01111111₂ = 127,尾数全 0,所以值是 1.0 × 20。
- 指数位决定数的量级,相当于科学计数法里的“× 10 的几次方”,只是底数是 2。8 位能存 0 到 255 的整数,减去偏置 127 得到真正的指数;0 和 255 留作特殊用途(零、次正规数、无穷和 NaN),所以正常数的指数范围是 −126 到 127,对应约 10−38 到 3.4×1038。
- 尾数位决定在同一量级内能分多细。相邻两个可表示数的间距是 2指数 − 127 − 23:数越小,间距越小。所以 fp32 在 0 附近能表示 10−38,在 1 附近的间距却是 2−23。
- 小数点前的 1 总是存在,标准省掉不存(隐含位),所以尾数只占小数点后的 23 位。最低位代表 2−23 ≈ 1.19×10⁻⁷:1.0 的下一个可表示数是 1 + 2−23。
- 1 + e−17.3:e−17.3 ≈ 3.05×10⁻⁸,比半个最低位 2−24 ≈ 5.96×10⁻⁸ 还小,只能落在第 24 位的虚线格里,就近舍入后结果仍是 1.0。这一个舍入就是 Softmax Collapse 的起因。
1起点:softmax 的标准实现
记号。一个样本在 \(K\) 个类别上的 logit 是向量 \(\mathbf z = (z_1, \dots, z_K) \in \mathbb R^K\)(粗体表示向量);\(z_k\) 是第 \(k\) 类的 logit,是一个标量。\(t \in \{1, \dots, K\}\) 是这个样本的正确类别,即训练数据给的标签,论文称为 target class,下文简称目标类;\(z_t\) 就是目标类那一个 logit 的数值。在图像分类里,目标类是图片的真实类别;在语言模型里,是训练文本中实际出现的下一个 token。交叉熵训练的作用就是把目标类的概率 \(q_t\) 推向 1。例如 \(\mathbf z = [9, -9, -9]\)、\(t = 1\) 时,\(z_t = 9\)。
对 logit \(\mathbf z\) 直接算 \(e^{z_k} / \sum_j e^{z_j}\),只要某个 logit 超过约 88(fp32 指数上限),\(e^{z}\) 就会上溢。所以所有框架都先减去最大值 \(z_{\max} = \max_j z_j\):
对目标分布 \(\mathbf p\),交叉熵 \(\mathcal L(\mathbf z, \mathbf p) = -\sum_k p_k \operatorname{logsoftmax}(\mathbf z)_k\),精确梯度是
梯度各分量之和为 0 是 softmax 的结构性质:把所有 logit 同时加一个常数不改变输出。下文的两个 bug 都表现为这个性质在浮点下被破坏,或者该为 0 的梯度不为 0。
2发现:两个数值 bug
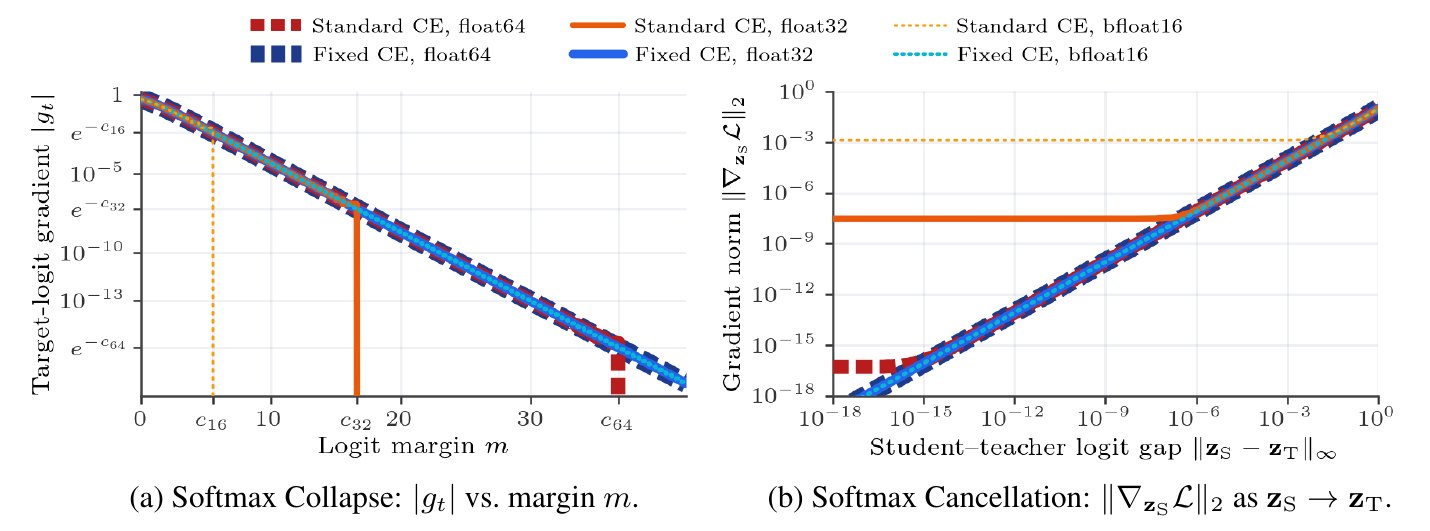
2.1 Softmax Collapse:自信的预测让目标梯度变成 0
设目标类别 \(t\) 的 logit 最大。用 logit margin 衡量模型有多自信,即目标 logit 比其余 logit 的 log-sum-exp 大多少:
下面从 softmax 的定义出发,推出“减去最大值”之后分母恰好是 \(1 + e^{-m}\)。目标类 \(t\) 的 logit 最大,所以 \(z_{\max} = z_t\)。每一步右侧注明所用的变换:
再看分子:\(k = t\) 时分子是 \(e^{z_t - z_t} = 1\)。所以目标类的概率是 \(q_t = 1/(1 + e^{-m})\),损失是 \(\mathcal L = -\log q_t = \log(1 + e^{-m})\)。以论文的例子 \(\mathbf z = [9, -9, -9]\) 验证:减去 9 后为 \([0, -18, -18]\),取指数为 \([1, e^{-18}, e^{-18}]\),其余两项之和 \(2e^{-18} = e^{-(18 - \ln 2)} \approx e^{-17.3}\);按式 (2),\(m = 9 - \log(2e^{-9}) = 18 - \ln 2 \approx 17.3\),两者一致。
对 \(\mathcal L = \log(1 + e^{-m})\) 求导,得到损失和梯度:
两种写法在实数上相等,在浮点上不同。这里的浮点格式指计算机用二进制存储实数的方式,深度学习里常用 bf16、fp32、fp64 三种。一个浮点数存成 \(\pm 1.f \times 2^{e}\):指数 \(e\) 决定数的量级范围,尾数 \(f\) 的位数 \(p\) 决定精度。每种格式的总位数固定,按 IEEE 754 等标准分给符号、指数和尾数三部分:
| 格式 | 总位数 | 符号 | 指数 | 尾数 p | 说明 |
|---|---|---|---|---|---|
| bf16 | 16 | 1 | 8 | 7 | 指数位与 fp32 相同,量级范围一样大,精度低得多 |
| fp32 | 32 | 1 | 8 | 23 | 32 − 1 − 8 = 23,所以小数点后只有 23 位 |
| fp64 | 64 | 1 | 11 | 52 |
小数点前的那个 1 不需要存:规格化的二进制数首位总是 1,标准把它省掉(隐含位),所以 fp32 实际有 24 位有效数字,但小数点后只有 23 位。给指数多分一位,能表示的量级就翻倍;给尾数多分一位,精度就翻倍。总位数固定时只能二选一,bf16 选择保住范围、牺牲精度。
这带来精度的不对称。在 \([1, 2)\) 区间里指数固定为 0,相邻两个可表示的数相差尾数最低位 \(2^{-p}\),fp32 中约为 \(1.2 \times 10^{-7}\);在 0 附近,指数可以取很小的负数,fp32 能表示到 \(10^{-38}\)。所以 \(e^{-m}\) 单独存放时很精确,加到 1 上之后只能保留到 \(2^{-p}\) 的整数倍。按就近舍入,当 \(e^{-m}\) 小于间距的一半 \(2^{-(p+1)}\) 时,\(1 + e^{-m}\) 被舍入为 1,即
| 格式 | 尾数位 p | 精度悬崖 cd = (p+1) ln 2 | 此时 e−m 的大小 |
|---|---|---|---|
| bf16 | 7 | ≈ 5.5 | 约 0.4%,模型给目标类 99.6% 的概率就到了 |
| fp32 | 23 | ≈ 16.6 | 约 6×10⁻⁸ |
| fp64 | 52 | ≈ 36.7 | 约 1×10⁻¹⁶ |
论文给出的三个悬崖值与上式一致,作者称之为 precision cliff。越过悬崖后,两种写法分道扬镳:
- 标准写法先算 \(q_t = 1/(1+e^{-m}) = 1/1 = 1\),再减 1,得到 \(\tilde g_t = 0\);前向的 \(\log(1+e^{-m})\) 也变成 \(\log 1 = 0\)。
- 非目标梯度 \(\tilde g_j = e^{z_j - z_t}/(1+e^{-m})\) 的分子直接由负数差算指数,不经过“加 1”,一直准确到指数下溢(\(m \approx 88\)),所以仍然为正。
- 结果:只有目标位置被清零,梯度之和变成 \(\sum_k \tilde g_k = e^{-m}/(1+e^{-m}) > 0\)(式 4)。
- 修复写法 \(-e^{-m}/(1+e^{-m})\) 把 \(e^{-m}\) 留在分子:分母舍成 1 也无妨,\(g_t \approx -e^{-m}\) 一直准确到下溢。
训练中各个 logit 怎么变。梯度下降沿 \(-\mathbf g\) 的方向更新 logit。目标类的 \(g_t = q_t - 1 < 0\),所以 \(z_t\) 被推高;非目标类的 \(g_j = q_j > 0\),所以每个 \(z_j\) 被压低。因为 \(\sum_k g_k = 0\),推高 \(z_t\) 的量正好等于压低所有 \(z_j\) 的总量,logit 的平均值不变,变的是差值 \(z_j - z_t\):它越来越负,margin \(m\) 越来越大。推力本身是 \(q_j = e^{z_j - z_t}/(1+e^{-m})\),随 margin 指数衰减,所以 \(z_j\) 被压低得越来越慢。实际训练更新的是网络参数,logit 只是间接改变,但方向由这里的梯度决定。越过悬崖后,标准写法中 \(z_t\) 的推力变成 0,\(z_j\) 仍被压低,两边不再平衡。
“[Softmax Collapse] rounds the target logit’s gradient to zero if that one logit is much larger than the others”摘要
动手看悬崖:拖动 margin,比较两种写法
| 标准 | 修复 |
|---|
每一步运算后都按所选格式舍入(fp32 用 Math.fround,bf16 在 fp32 基础上按就近偶数截到 7 位尾数)。初始值 m = 17.3 对应论文的例子 z = [9, −9, −9]:m = 18 − ln 2。
用 PyTorch 在 fp32 下复现论文的例子(修复函数的实现见第 5 节):
# z = [9.0, -9.0, -9.0], t = 0, fp32, PyTorch 2.11
F.log_softmax(z, dim=-1)     # -> [ 0.0,       -18.0,     -18.0    ]
F.cross_entropy(z, t)        # -> 0.0,       grad [ 0.0,       1.523e-8,  1.523e-8]   梯度和 > 0
log_softmax_fixed(z)         # -> [-3.046e-8,  -18.0,     -18.0    ]
cross_entropy_fixed(z, t)    # -> 3.046e-8,  grad [-3.046e-8,  1.523e-8,  1.523e-8]   梯度和 = 0
2.2 Softmax Cancellation:学生等于老师时梯度不为 0
知识蒸馏和 KL 正则里,目标分布来自另一组 logit:\(\mathbf p = \operatorname{softmax}(\mathbf z_T)\)。标准实现分别算出 \(\mathbf q = \operatorname{softmax}(\mathbf z_S)\) 和 \(\mathbf p\),再相减得到梯度 \(\tilde{\mathbf g} = \mathbf q - \mathbf p\)。这里有两个问题:
- 相近数相减。学生 logit 逼近老师时,\(\boldsymbol\delta = \mathbf z_S - \mathbf z_T\) 很小,但 \(\mathbf q\) 和 \(\mathbf p\) 先被舍入成概率,\(\boldsymbol\delta\) 的信息在相减前已经丢了。
- 前向与反向的公式不同。前向用 \(\operatorname{softmax}(\mathbf z_T)\) 算 \(\mathbf p\),反向用 \(\exp(\operatorname{logsoftmax}(\mathbf z_S))\) 算 \(\mathbf q\)。两条运算路径的舍入误差不同,即使 \(\mathbf z_S = \mathbf z_T\),\(\mathbf q - \mathbf p\) 也不为 0。
“slight differences between the forward-pass softmax and backward-pass log-softmax formulas leave a non-zero gradient even when zS = zT”§1
论文的例子:老师 logit \(\mathbf z_T = [2, 1, 0]\),学生在 fp32 下差一个微小扰动 \([-10^{-7}, 10^{-7}, 0]\)。
| 实现 | g1 | g2 | g3 | 问题 |
|---|---|---|---|---|
| 标准 soft-target CE(fp32,论文中 JAX 的结果) | −5.960464e-8 | 1.451589e-8 | −1.123343e-9 | 第 2 项缩小约 3 倍,第 3 项符号反了,和不为 0 |
| 修复版(fp32) | −4.595504e-8 | 4.144190e-8 | 4.513142e-9 | 与 fp64 精确值一致 |
| 精确值(fp64) | −4.595504e-8 | 4.144190e-8 | 4.513142e-9 |
3现象:Slingshot 尖峰
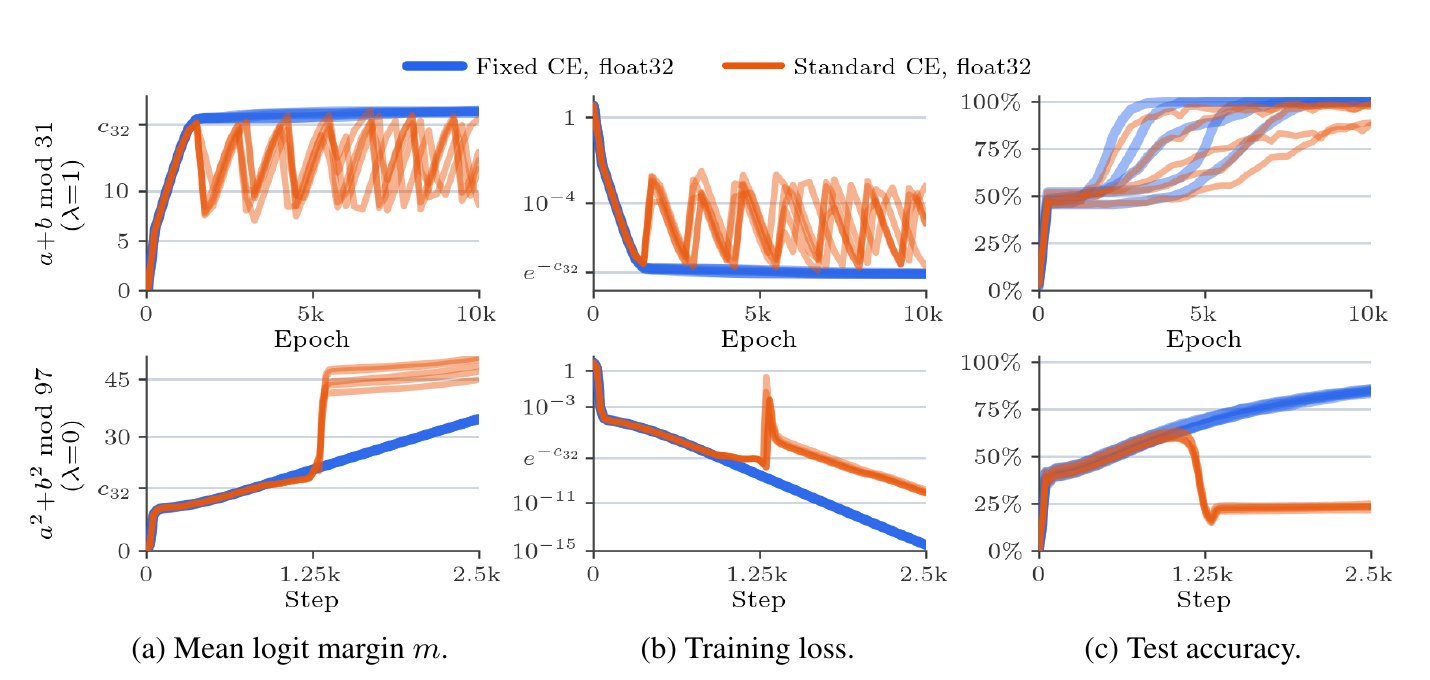
Grokking(Power et al., 2022)指网络很快记住训练集(\(q_t \to 1\)),很久以后才在测试集上泛化。Thilak et al.(2022)在模加法上用 Adam 训练时观察到 Slingshot 机制:记住训练集之后,训练 loss 在接近 0 的平台和突然的尖峰之间反复交替,尖峰常与测试准确率的跳升同时出现。这篇论文把它归因到 Softmax Collapse。
“These Slingshot spikes are a direct consequence of Softmax Collapse”§4
关键在 AdamW 的更新 \(\theta \leftarrow \theta - \eta\,\hat m / (\sqrt{\hat v} + \epsilon) - \lambda\theta\)(写法同原文):它用梯度平方的滑动平均 \(\hat v\) 做归一化。一个循环如下:
- 越过悬崖记住训练集后 margin 持续增长。一批样本都越过 \(c_d\) 后,目标梯度被舍为 0,参数梯度几乎消失。
- 二阶矩衰减梯度接近 0,Adam 的 \(\hat v\) 按 \(\beta_2\) 指数衰减到很小;权重衰减同时慢慢缩小参数。
- 梯度恢复权重衰减或残余的非目标梯度把部分样本拉回悬崖以下,目标梯度 \(\approx -e^{-m}\) 突然恢复。
- 巨步更新恢复的梯度除以极小的 \(\sqrt{\hat v} + \epsilon\),得到一个很大的参数步:训练 loss 尖峰,\(\hat v\) 被重置。
④ 之后 margin 重新增长,回到 ①,循环往复。
“Adam divides the restored gradients by a very small denominator”§4
修复后,目标梯度 \(-e^{-m}/(1+e^{-m})\) 在悬崖处不会归零,\(\hat m\) 与 \(\hat v\) 平滑地一同衰减,尖峰随之消失。
4影响
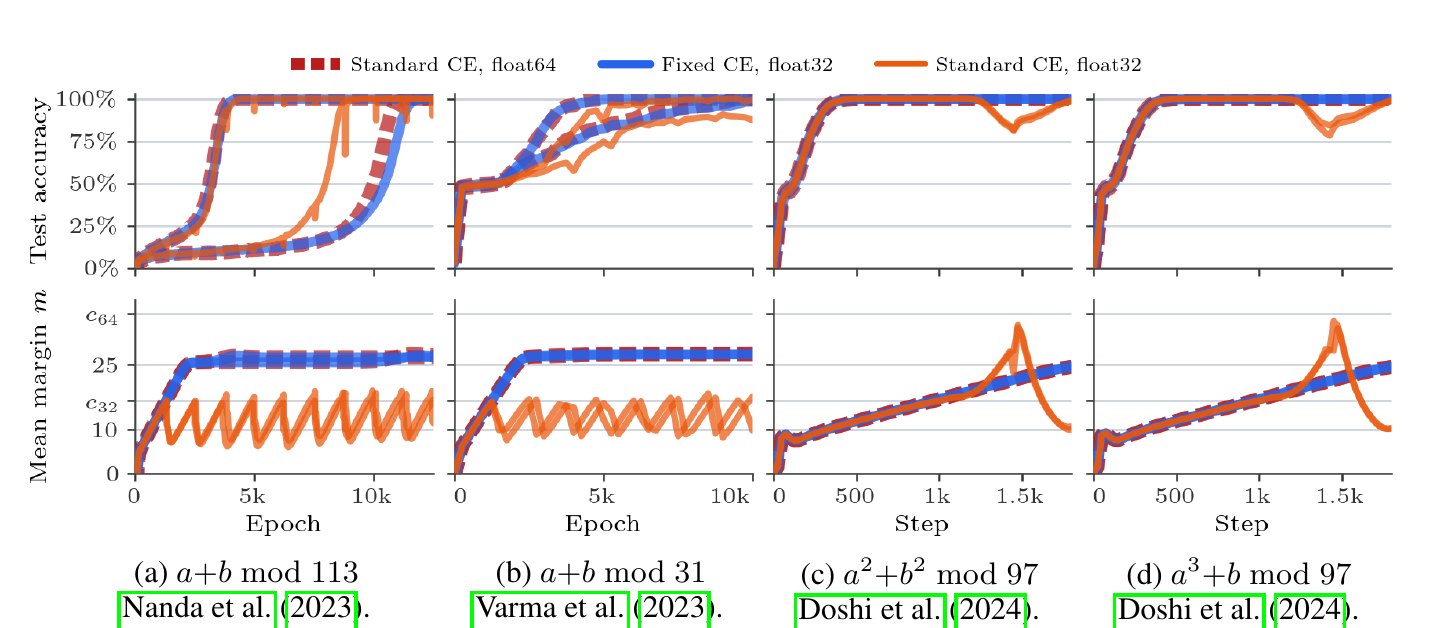
4.1 尖峰是帮倒忙还是帮忙,取决于权重范数怎么控制
尖峰看起来有益
输出层前有 LayerNorm 时,放大权重不改变 logit,但会缩小有效步长 \(\eta/\|\theta\|_2\)。每次尖峰都会放大 \(\|\theta\|_2\),相当于一次意外的学习率衰减。
尖峰减慢 grokking
权重范数已由权重衰减控制,尖峰只会拖慢并损害泛化:\(a+b \bmod 31\) 上测试准确率为 94 ± 5%,修复后为 100 ± 0%。
一次尖峰就是灾难
\(a^2+b^2 \bmod 97\) 上测试准确率从 61% → 23%,\(a^3+b \bmod 97\) 上从 60% → 21%;修复版继续升到 85%。
“each Slingshot spike inflates ‖θ‖2 and acts as an accidental learning-rate decay”§4
这解释了为什么先前文献对 Slingshot 的评价不一:有人看到它伴随泛化,有人看到它破坏训练,区别在于实验设置里是否有 LayerNorm 和权重衰减。
4.2 修复之后,margin 停在哪:\(m^\star \approx \log(1/\epsilon)\)
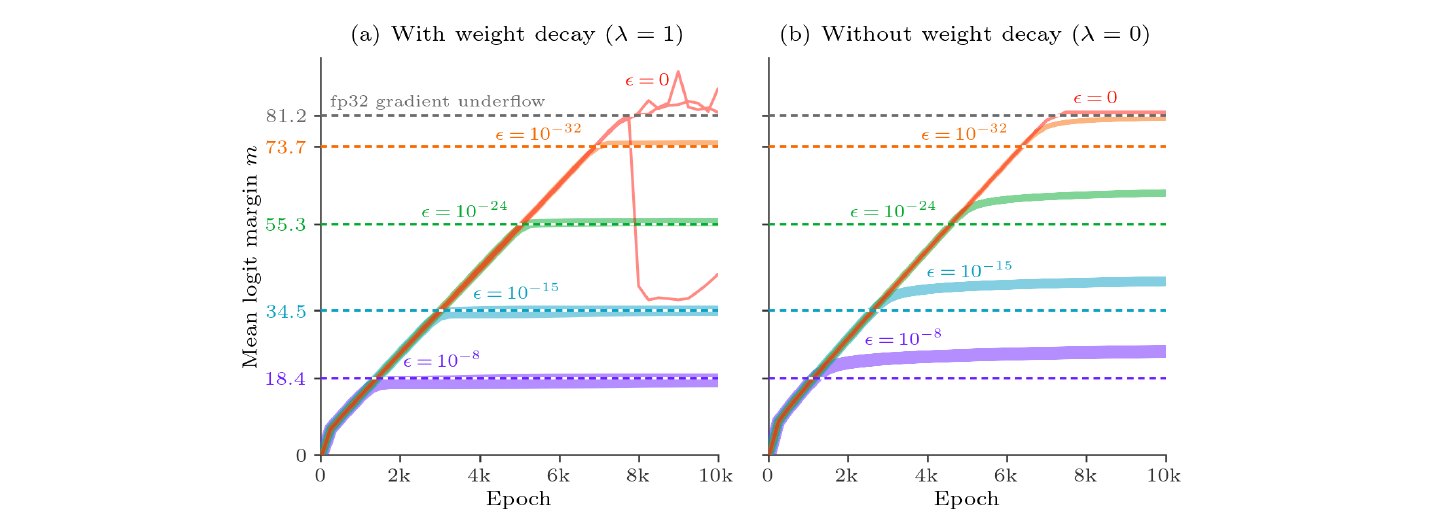
Figure 2 上行里,修复版越过悬崖后 margin 停在 18.4 附近,不再增长;没有权重衰减时(下行)则一直增长。这个平台与浮点精度无关:
“This plateau has nothing to do with fp32 precision”§5
推导分三步。
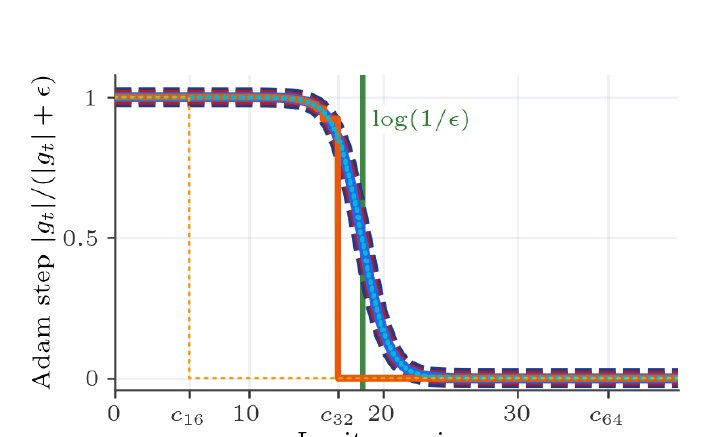
- 平稳点条件。参数不再变化时,滑动平均收敛到 \(\hat m_i = g_i\),\(\sqrt{\hat v_i} = |g_i|\)。令 AdamW 更新为 0:
\[ \frac{g_i}{|g_i| + \epsilon} + \lambda\theta_i = 0 \quad \forall i . \]式 (10)学习率 \(\eta\) 和 \(\beta_1, \beta_2\) 都消掉了,所以 RMSProp 和 LaProp 有同样的平稳点。
- 归一化步长随 margin 衰减。记住训练集后梯度随 margin 指数缩小,\(|g_i| \propto e^{-m}\)。若 \(\epsilon = 0\),归一化后的步长 \(g_i/|g_i| = \operatorname{sign}(g_i)\) 恒为 1,margin 会一直涨到梯度下溢;若 \(\epsilon > 0\),当 \(|g_i| \gg \epsilon\) 时步长约为 1,当 \(|g_i| \ll \epsilon\) 时步长约为 \(g_i/\epsilon \propto e^{-m}\)。
- 与权重衰减平衡。缩小的步长与 \(\lambda\theta_i\) 平衡需要 \(|g_i| \approx \epsilon\lambda|\theta_i|\),代入 \(|g_i| \propto e^{-m}\):
\[ m^\star(\epsilon) \approx \log(1/\epsilon) . \]式 (11)
把三种格式的悬崖和几个 \(\epsilon\) 的平衡点画在同一条 margin 轴上,就能看出标准 CE 什么时候出事:平衡点在悬崖右边,margin 就会在到达平衡之前先撞上悬崖。
- 默认 \(\epsilon = 10^{-8}\) 恰好坏在 fp32:平衡点 18.4 在 fp32 悬崖 16.6 的右边,所以标准 CE 在 fp32 下几乎必然触发 Slingshot。若 \(\epsilon \ge 10^{-7}\),平衡点 \(\le 16.1\),在悬崖左边,标准 CE 不会出尖峰。
- bf16 的悬崖 5.5 在所有平衡点左边:标准 CE 在 bf16 下总会卡在 5.5 附近(表 1 中 bf16 标准 CE 的最终 margin 为 5.1–5.8)。
- fp64 也不安全:\(\epsilon = 10^{-16}\) 时平衡点 36.8 刚好越过 fp64 悬崖 36.7,fp64 标准 CE 也会出问题。
4.3 跨精度、跨基准
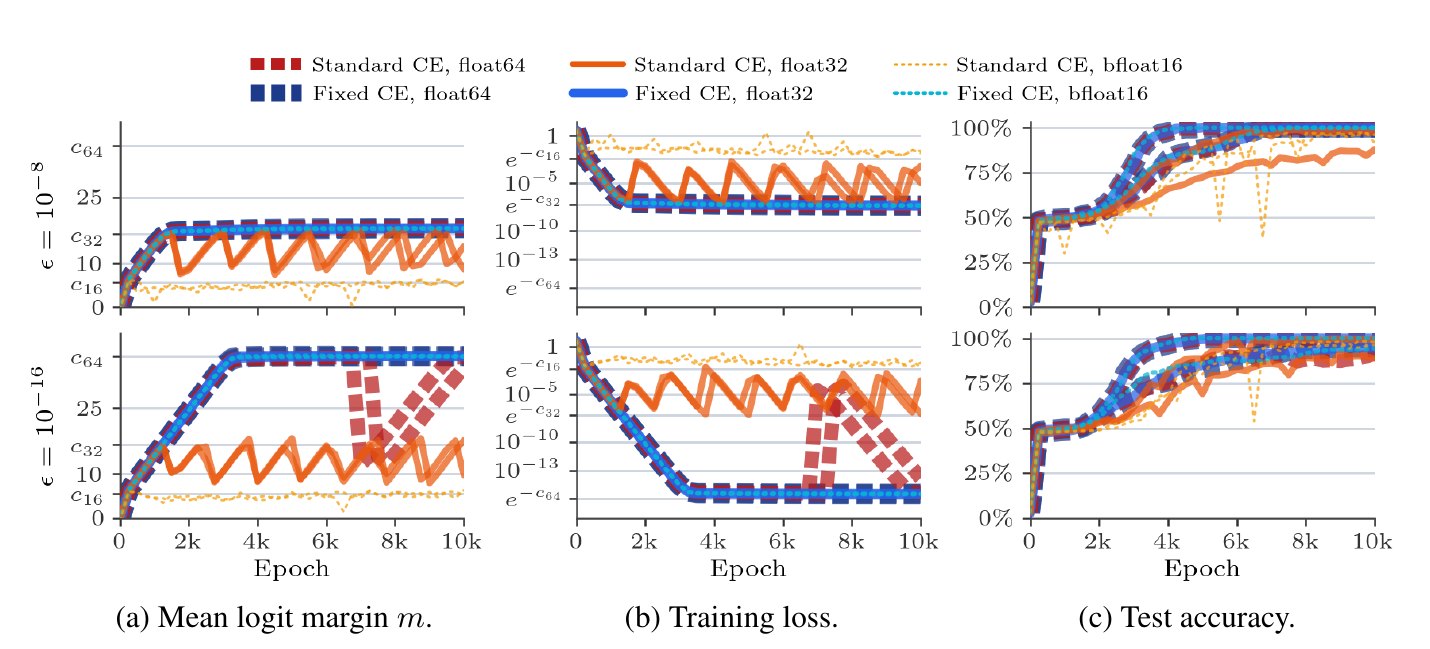
设置沿用 Varma et al.(2023):1 层、宽 64 的 ReLU Transformer,\(a+b \bmod 31\),50% 训练集,全批量 AdamW 训练 10,000 epoch。只改变损失函数、浮点格式和 \(\epsilon\),另外对比两种已有的补救方法。
| 方法 | ε = 1e-8 | 1e-12 | 1e-16 | 最终 margin(1e-8 / 1e-12 / 1e-16) |
|---|---|---|---|---|
| fp32 修复 CE | 100.0 ± 0.0 | 99.6 ± 0.7 | 99.0 ± 2.3 | 17.9 / 27.4 / 36.8 |
| fp32 标准 CE | 94.3 ± 5.4 | 96.4 ± 5.1 | 96.5 ± 4.3 | 13.0 / 15.1 / 12.7 |
| bf16 修复 CE | 100.0 ± 0.1 | 99.8 ± 0.2 | 98.9 ± 2.4 | 17.9 / 27.4 / 36.8 |
| bf16 标准 CE | 93.3 ± 7.4 | 94.9 ± 4.9 | 94.2 ± 8.3 | 5.1 / 5.6 / 5.8 |
| fp64 修复 CE | 100.0 ± 0.0 | 99.5 ± 1.1 | 99.0 ± 2.0 | 17.9 / 27.4 / 36.8 |
| fp64 标准 CE | 100.0 ± 0.0 | 100.0 ± 0.1 | 97.2 ± 3.2 | 17.9 / 27.4 / 30.1 |
| fp32 零和投影(Liu et al., 2026) | 97.9 ± 3.2 | 48.9 ± 2.6 | 49.3 ± 2.5 | 17.0 / 18.9 / 18.9 |
| fp32 StableMax(Prieto et al., 2025) | 97.3 ± 4.7 | 95.6 ± 2.0 | 97.3 ± 4.3 | 3200 / 5661 / 6313 |
| fp64 StableMax(Prieto et al., 2025) | 97.4 ± 4.2 | 96.7 ± 5.3 | 95.6 ± 2.7 | 3170 / 21252 / 2322 |
原文 Table 1,测试准确率(%),5 个种子。修复 CE 的最终 margin 与预测的 \(\log(1/\epsilon) = 18.4, 27.6, 36.8\) 吻合,且三种精度完全相同;标准 CE 停在各自悬崖附近。
读表的三个要点:
- 修复后,bf16 和 fp64 的结果一样好。这里的失败来自实现,而非低精度本身。
- 零和投影把梯度均值减掉,强制和为 0。但目标梯度已经是 0 时,它只分到非目标梯度总和的 \(-1/K\),margin 卡在 18 附近,\(\epsilon \le 10^{-12}\) 时准确率跌到 50% 以下。
- StableMax 把 softmax 里的 \(\exp(x)\) 换成分段有理函数(\(x \ge 0\) 时为 \(x+1\),\(x < 0\) 时为 \(1/(1-x)\))。它线性增长,margin 涨到 \(10^3\)–\(10^4\),准确率在所有 \(\epsilon\) 下都低于修复 CE。
4.4 蒸馏:学生从老师身边漂走
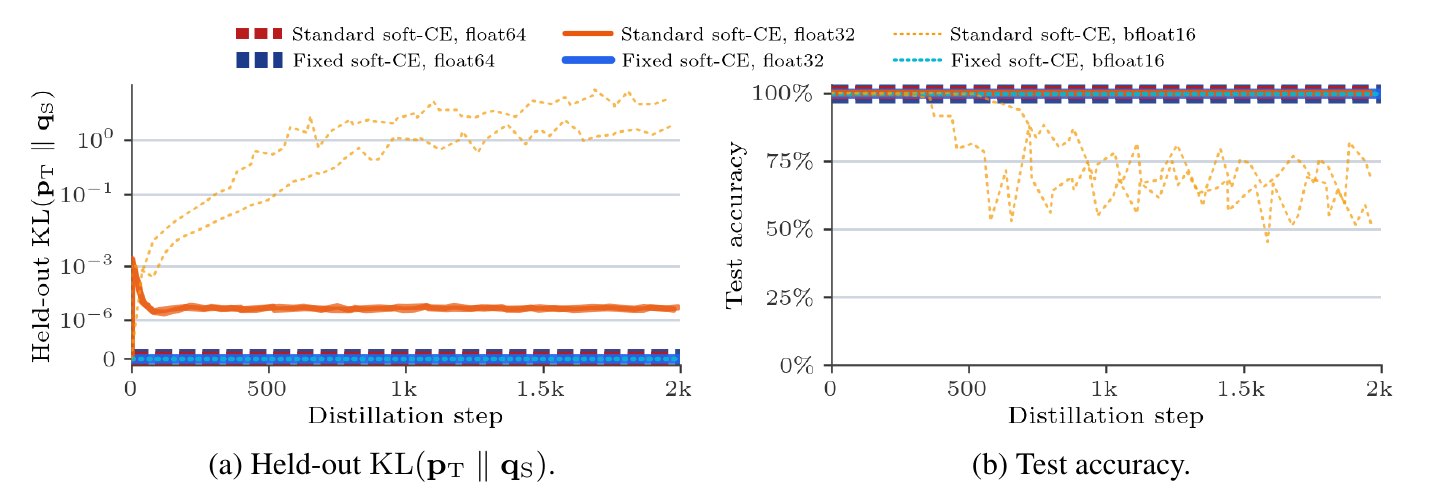
实验设计很直接:先把老师训到 \(a+b \bmod 53\) 上 100% 测试准确率,再用老师的权重初始化学生(\(\theta_S^{(0)} = \theta_T\)),在温度 \(T = 4\) 下用 Adam(\(\eta = 2\times10^{-3}\),\(\lambda = 0\),\(\epsilon = 10^{-8}\))蒸馏 2000 步。初始时 \(\mathbf z_S = \mathbf z_T\),真实梯度为 0,学生本该一动不动。
标准实现在 \(\mathbf z_S = \mathbf z_T\) 处留有残余梯度。只要残余大于 \(\epsilon\),Adam 就会把它归一化成大小约为 \(\eta\) 的步长:
| 格式 | 残余梯度 | 与 ε = 1e-8 比 | 结果 |
|---|---|---|---|
| fp64 | ~1e-17 | 远小于 ε | 学生基本不动,KL ≈ 0 |
| fp32 | ~1e-8 | 与 ε 相当 | KL 短暂尖峰 |
| bf16 | ~1e-3 | 远大于 ε | 学生被推离老师,测试准确率下降 |
修复版在 \(\mathbf z_S = \mathbf z_T\) 时梯度精确为 0,三种精度下学生都停在 KL = 0、准确率 100%。
5修复:在 log 空间里重写,永远不把 1 加到小数上
5.1 修 Softmax Collapse:用 softplus 代替 1 + e−m
记号 LSE。LSE 是 log-sum-exp 的缩写:先对每个数取指数,求和,再取对数,
右边的不等式说明 LSE 是“平滑的最大值”:结果总落在最大值和最大值加 \(\log n\) 之间。框架里的 logsumexp 会先减去最大值再取指数,所以不会上溢。用 LSE 可以把式 (2) 的 margin 改写成只含 logit 差的形式:
所以 \(m = -\operatorname{LSE}_{j \ne t}(z_j - z_t)\)。以 \(\mathbf z = [9, -9, -9]\)、\(t = 1\) 为例:两个非目标类的差都是 \(-18\),\(\operatorname{LSE}(-18, -18) = \log(2e^{-18}) = -18 + \ln 2 \approx -17.3\),于是 \(m \approx 17.3\),与前面一致。
只有最大的 logit 被平移成 0(贡献分母里的那个 1)。修复的做法是把它从 log-sum-exp 中拿出来,单独算 margin,再用数值稳定的 \(\operatorname{softplus}(x) = \log(1+e^x)\) 合并:
硬目标交叉熵可以直接用 \(t\) 代替 \(i_{\max}\),省掉 argmax:
关键在于:第 \(t\) 个位置被替换成常数 0,而不是 \(z_t - z_t\),于是 \(z_t\) 只通过 \(K-1\) 个差 \(z_j - z_t\) 进入损失。自动微分给出的目标梯度自然等于非目标梯度之和的相反数,和为 0 由构造保证,不依赖舍入:
把两种实现逐步摆在一起,以 \(\mathbf z = [9, -9, -9]\)、\(t = 1\)、fp32 为例,每格下方是实际算出的数值(PyTorch 2.11)。橙色格是舍入出错的步骤:
| 步骤 | 修复前(标准实现) | 修复后 |
|---|---|---|
| ① 平移 | \(\tilde z_k = z_k - z_t\),目标位置 \(\tilde z_t = z_t - z_t = 0\) [0, −18, −18] | 只对非目标位置做差 \(z_j - z_t\);目标位置直接放常数 0 [0, −18, −18],其中 0 不依赖 z_t |
| ② 合并 | \(S = \sum_k e^{\tilde z_k} = 1 + e^{-m}\):把 \(e^{-m}\) 加到 1 上 1 + 3.046e-8 → 舍入为 1.0 | \(m = -\operatorname{LSE}_{j \ne t}(z_j - z_t)\):只对非目标项求 log-sum-exp,不出现 1 m = 18 − ln 2 = 17.307 |
| ③ 损失 | \(\mathcal L = -\tilde z_t + \log S = \log(1 + e^{-m})\) log 1.0 = 0(真值 3.046e-8) | \(\mathcal L = \operatorname{softplus}(-m) = \operatorname{log1p}(e^{-m})\) 3.046e-8 |
| ④ 目标梯度 | \(g_t = q_t - 1 = 1/S - 1\) 1.0 − 1 = 0(真值 −3.046e-8) | \(g_t = -\sum_{j \ne t} g_j\),由自动微分经 \(z_j - z_t\) 得到 −3.046e-8 |
| ⑤ 非目标梯度 | \(g_j = e^{z_j - z_t}/S\) 1.523e-8(分子准确) | \(g_j = e^{z_j - z_t}/(1 + e^{-m})\) 1.523e-8 |
| ⑥ 梯度和 | \(\sum_k g_k = e^{-m}/(1+e^{-m})\) 3.046e-8 ≠ 0 | \(\sum_k g_k = 0\),由构造保证 0 |
左边是 PyTorch 内置函数(修复前),右边是按论文式 (5)–(7) 写的修复版。两边接口相同,可以直接替换。
import torch
import torch.nn.functional as F

# 直接调用内置函数
logp = F.log_softmax(z, dim=-1)
loss = F.cross_entropy(z, t)

# 内置实现等价于:
#   前向  log_softmax = (z - z_max) - log Σ exp(z - z_max)
#         目标位置 = 0 - log(1 + e^-m)
#         m 越过悬崖后 1 + e^-m 舍成 1,loss = 0
#   反向  grad = softmax(z) - onehot(t)
#         q_t 舍成 1,目标梯度 = 1 - 1 = 0
#         非目标梯度 q_j 仍为正,梯度和 > 0
import torch
import torch.nn.functional as F

def log_softmax_fixed(z):
    i_max = z.argmax(dim=-1, keepdim=True)
    z_max = z.gather(-1, i_max)
    is_max = torch.zeros_like(z, dtype=torch.bool)
    is_max.scatter_(-1, i_max, True)
    # argmax 处放常数 0,不经过 z_max - z_max
    shifted = torch.where(is_max, torch.zeros_like(z), z - z_max)
    # 把 argmax 排除出求和,单独算 margin
    others = shifted.masked_fill(is_max, float("-inf"))
    m = -torch.logsumexp(others, dim=-1, keepdim=True)
    # softplus(-m) = log(1 + e^-m),不把 e^-m 加到 1 上
    return shifted - F.softplus(-m)

def cross_entropy_fixed(z, t):
    z_t = z.gather(-1, t[..., None])
    is_t = F.one_hot(t, z.shape[-1]).bool()
    # 把目标排除出求和:m = -LSE_{j≠t}(z_j - z_t)
    others = (z - z_t).masked_fill(is_t, float("-inf"))
    m = -torch.logsumexp(others, dim=-1)
    return F.softplus(-m)    # = -log_softmax(z)[t]
在 fp32 下用论文的例子 \(\mathbf z = [9, -9, -9]\)、\(t = 0\) 运行(PyTorch 2.11,CPU):
# loss 及 z.grad
F.cross_entropy(z, t)        # -> 0.0,       [ 0.0,       1.523e-8,  1.523e-8]   梯度和 = 3.046e-8
cross_entropy_fixed(z, t)    # -> 3.046e-8,  [-3.046e-8,  1.523e-8,  1.523e-8]   梯度和 = 0
F.log_softmax(z, dim=-1)     # -> [ 0.0,       -18.0,     -18.0    ]
log_softmax_fixed(z)         # -> [-3.046e-8,  -18.0,     -18.0    ]
一个容易误解的细节:如果把标准公式 (z - z_max) - log(exp(z - z_max).sum()) 自己写出来再交给 autograd,前向的 loss 仍会舍成 0,但 autograd 会经过 z_max 的梯度把目标梯度算对。梯度被清零的是内置函数的融合反向 softmax(z) - onehot(t),它先把 \(q_t\) 舍成 1 再减 1。
5.2 修 Softmax Cancellation:直接从 logit 差算 q − p
不再分别算两个概率再相减,而是把老师 logit 直接传进损失函数,用 \(\boldsymbol\delta = \mathbf z_S - \mathbf z_T\) 在 log 空间里算 \(\mathbf q - \mathbf p\)。借助 \(\operatorname{expm1}(x) = e^x - 1\) 和 \(\operatorname{log1p}(x) = \log(1+x)\),全程不出现“加 1”或“减 1”:
因为 \(\sum_i p_i d_i = 0\) 且 \(\operatorname{expm1}(x) \ge x\),log1p 的输入总是非负。最后再做一次 \(g_k = u_k - q_k \sum_i u_i\),消去剩余的浮点漂移,保证和为 0。\(\boldsymbol\delta = 0\) 时 \(\mathbf d = \mathbf s = \mathbf u = \mathbf 0\),梯度精确为 0。
同样逐步对照,以 §2.2 的例子为例(\(\mathbf z_T = [2, 1, 0]\),fp32,PyTorch 2.11);第 ⑥ 行换成学生等于老师的情形:
| 步骤 | 修复前(标准实现) | 修复后 |
|---|---|---|
| ① 起点 | 先分别算概率 \(\mathbf q = \exp(\operatorname{logsoftmax}(\mathbf z_S))\),\(\mathbf p = \operatorname{softmax}(\mathbf z_T)\),各自舍入 p ≈ [0.665, 0.245, 0.090] | 直接在 logit 上做差 \(\boldsymbol\delta = \mathbf z_S - \mathbf z_T\) δ = [−1e-7, 1e-7, 0] |
| ② 居中 | — | \(d_k = \delta_k - \sum_i p_i \delta_i\) |
| ③ 对数比 | — | \(s_k = \log(q_k/p_k) = d_k - \operatorname{log1p}\big(\sum_i p_i \operatorname{expm1}(d_i)\big)\) |
| ④ 求差 | \(g_k = q_k - p_k\):两个约 0.1–0.7 的数相减,结果约 \(10^{-8}\),有效位几乎全部抵消 [−5.960e-8, 4.470e-8, 7.451e-9] | \(u_k = q_k - p_k = p_k \operatorname{expm1}(s_k)\):expm1 对小量精确 [−4.596e-8, 4.144e-8, 4.513e-9] |
| ⑤ 零和 | 不保证 和 = −7.5e-9 | \(g_k = u_k - q_k \sum_i u_i\) 和 ≈ 2e-15 |
| ⑥ \(\mathbf z_S = \mathbf z_T\) 时 | 两条路径舍入不同,\(\mathbf q \ne \mathbf p\) [5.960e-8, 1.490e-8, 7.451e-9] | \(\boldsymbol\delta = 0 \Rightarrow \mathbf d = \mathbf s = \mathbf u = \mathbf g = 0\) [0, 0, 0] |
import torch
import torch.nn.functional as F

def soft_target_ce_std(z_S, z_T):
    # 前向用 softmax 算 p
    p = torch.softmax(z_T, dim=-1)
    return -(p * F.log_softmax(z_S, dim=-1)).sum(-1)

# 反向:grad = q - p
#   q 来自 exp(log_softmax(z_S)),p 来自 softmax(z_T)
#   两个已舍入的概率相减,z_S ≈ z_T 时丢精度
# 两条路径舍入不同,z_S = z_T 时也不为 0def soft_target_ce_fixed(z_S, z_T):
log_q = log_softmax_fixed(z_S)
q, p = log_q.exp(), log_softmax_fixed(z_T).exp()
delta = z_S - z_T
# 在 p 下居中
d = delta - (p * delta).sum(-1, keepdim=True)
# s = log(q / p),用 expm1 / log1p 避免加减 1
s = d - torch.log1p((p * torch.expm1(d)).sum(-1, keepdim=True))
# u = q - p
u = p * torch.expm1(s)
# 消去浮点漂移,保证 sum(g) = 0
g = u - q * u.sum(-1, keepdim=True)
# 前向值不变,反向梯度替换成 g
loss = -(p * log_q.detach()).sum(-1)
return loss + (g.detach() * (z_S - z_S.detach())).sum(-1)用 §2.2 的例子运行(fp32,PyTorch 2.11,CPU)。PyTorch 标准写法的数值与论文的 JAX 结果不完全相同,但问题一样:第 3 项偏大约 65%,梯度和不为 0,学生等于老师时梯度也不为 0。
# z_T = [2, 1, 0],z_S = z_T + [-1e-7, 1e-7, 0]:z_S.grad
soft_target_ce_std     # -> [-5.960e-8,  4.470e-8,  7.451e-9]   和 = -7.5e-9
soft_target_ce_fixed   # -> [-4.596e-8,  4.144e-8,  4.513e-9]   和 ≈ 2e-15
# 精确值(fp64)           [-4.596e-8,  4.144e-8,  4.513e-9]

# z_S = z_T:真实梯度为 0
soft_target_ce_std     # -> [ 5.960e-8,  1.490e-8,  7.451e-9]
soft_target_ce_fixed   # -> [ 0.0,       0.0,       0.0     ]
5.3 与已有补救方法比较
| 方法 | 做法 | 局限 |
|---|---|---|
| 转成 fp64(Nanda et al., 2023;Varma et al., 2023) | 在更高精度下算 softmax 和 CE | 只是把悬崖从 16.6 推到 36.7;\(\epsilon = 10^{-16}\) 时 fp64 也失败 |
| 零和投影(Liu et al., 2026) | 梯度减去均值,强制和为 0 | 目标梯度为 0 时只分到 \(-1/K\),margin 卡在约 18 |
| StableMax(Prieto et al., 2025) | 用线性增长的函数代替 exp | 改变了损失本身,margin 涨到 \(10^3\)–\(10^4\),准确率更低 |
| 本文 | 用 softplus / expm1 / log1p 在 log 空间重写 | 损失在数学上不变,可以直接替换,没有明显的额外开销 |
6讨论
作者自己也指出了适用范围:
“Though the extreme margins and near-zero student–teacher gaps probed by our experiments are uncommon in standard large-scale training, our fixed functions are easy drop-in replacements”§8
- 大模型训练会碰到悬崖吗?实验全部在小型 grokking 任务上。LLM 预训练里 CE 通常在什么精度下算?高频、确定性强的 token 的 margin 能否超过 16.6?如果 logits 在 bf16 下算 CE,悬崖只有 5.5,即目标类概率约 99.6%。
- RL 微调里的 KL 项是 Softmax Cancellation 的典型场景。训练初期策略 \(\pi\) 与参考模型 \(\pi_{\text{ref}}\) 几乎相同,KL 及其梯度本应接近 0。PPO / GRPO 的重要性比率 \(\pi/\pi_{\text{old}}\) 在每轮第一个更新步也恰好等于 1。我们的实现是怎么算这两项的?
- Adam 的 \(\epsilon\) 隐式限定了自信程度。式 (11) 说明 \(\epsilon\) 与权重衰减共同决定 margin 的上限 \(\log(1/\epsilon)\)。它和 label smoothing、z-loss 这类显式控制 logit 的手段是什么关系?调 \(\epsilon\) 是否等价于调一个正则项?
- “低精度不稳定”有多少是实现问题?修复后 bf16 与 fp64 结果一样。我们见过的 bf16 训练尖峰里,有多少可以归到类似的“加 1 再减 1”式写法?
7参考
- Barron, Gnanapragasam, Tschannen. A Fix for Softmax and Cross-Entropy. arXiv 2610.31642, 2026.
- Thilak et al. The Slingshot Mechanism: An Empirical Study of Adaptive Optimizers and the Grokking Phenomenon. arXiv 2206.04817, 2022.
- Power et al. Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets. arXiv 2201.02177, 2022.
- Prieto et al. Grokking at the Edge of Numerical Stability(StableMax). ICLR 2025.
- Liu et al. Grokking or Glitching? How Low-Precision Drives Slingshot Loss Spikes(零和投影). arXiv 2605.06152, 2026.
- Varma et al. Explaining Grokking through Circuit Efficiency. arXiv 2309.02390, 2023.
- Nanda et al. Progress Measures for Grokking via Mechanistic Interpretability. ICLR 2023.
- Doshi et al. Grokking Modular Polynomials. arXiv 2406.03495, 2024.
- Hinton, Vinyals, Dean. Distilling the Knowledge in a Neural Network. arXiv 1503.02531, 2015.
Comments