用 RL 训练 LLM 多智能体系统时,常见的设置是:一个 orchestrator 拆解任务、派生多个 sub-agent 分头执行,再汇总作答;环境只对最终答案给出一个奖励。训练需要把这一个奖励转化为每个 agent、每一步的学习信号,也就是判断任务的成败中哪个 agent、哪一步起了作用,这就是多智能体信用分配问题。本文依次介绍背景、LLM RL 的训练流程、经典 MARL 的信用分配方法和 LLM 多智能体训练中的新做法,最后讨论未来方向。
1背景:LLM 多智能体系统的 RL 训练
LLM 多智能体系统由多个 LLM agent 协作完成一个任务。常见的组织方式有三类:
orchestrator + sub-agent
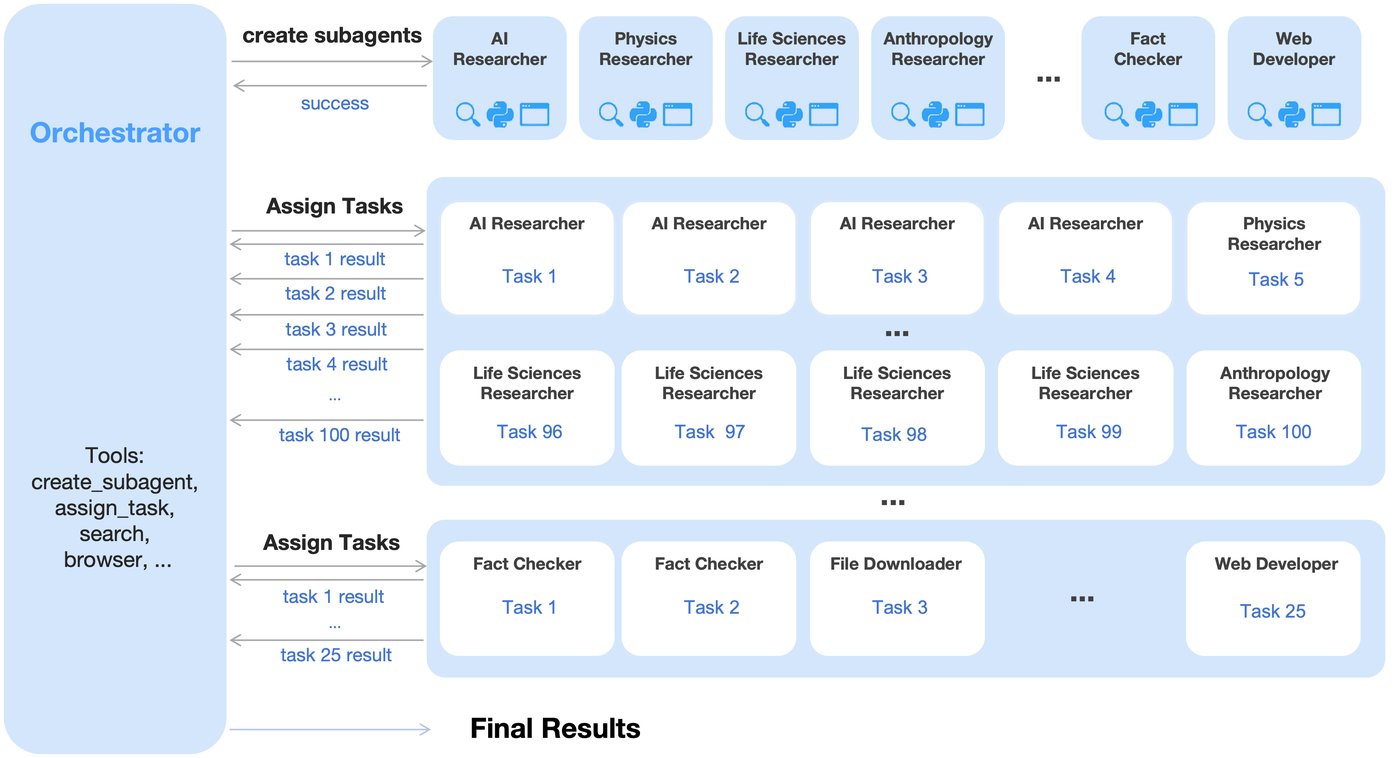
orchestrator 拆解任务、按需派生 sub-agent 并行执行,再汇总结果。例如 Kimi K2.5 的 Agent Swarm。
固定数量的 agent 共同求解
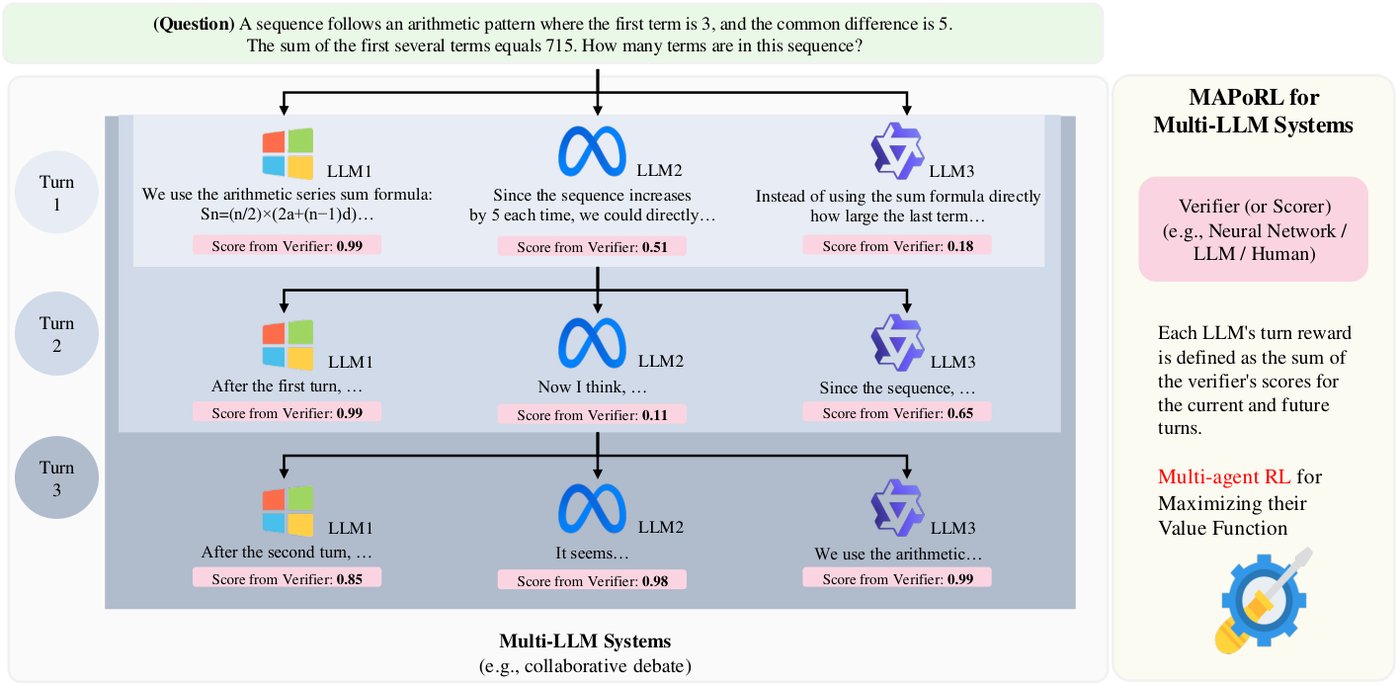
多个 agent 各自作答或分工产出,经多轮交流后给出最终结果。例如 MAGRPO、MAPoRL。
agent 在博弈中扮演角色
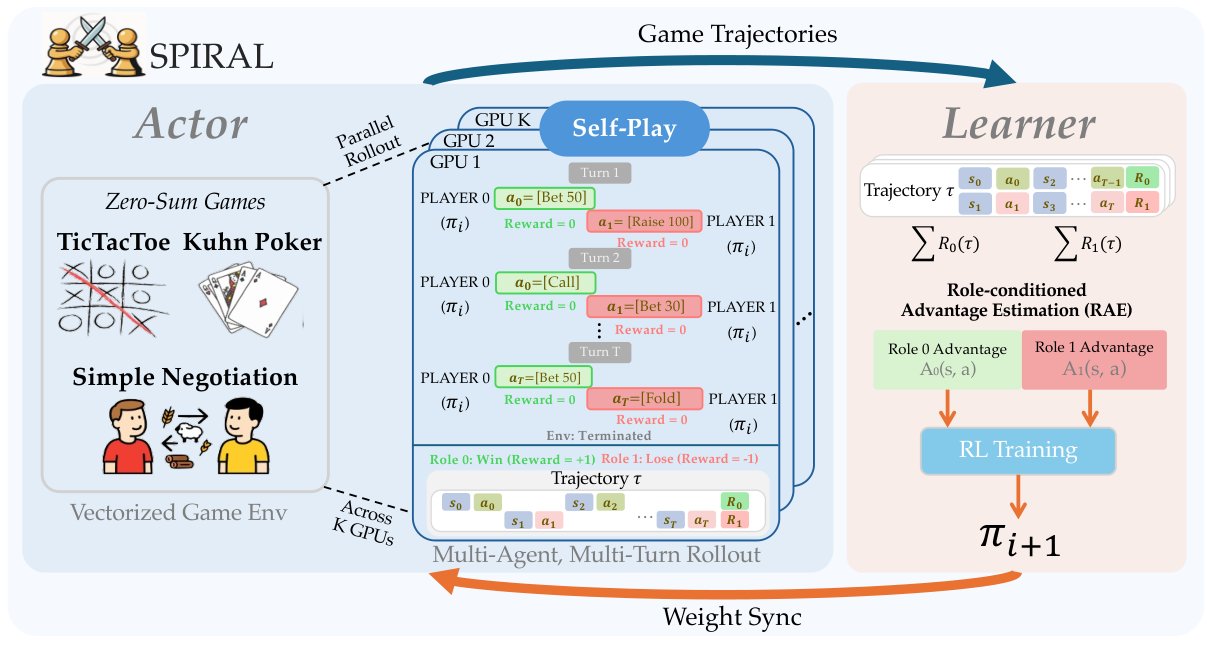
agent 在多人游戏中扮演固定角色,相互对抗或合作。例如 SPIRAL、MARSHAL 的自我对弈。
这类系统起初多靠提示工程搭建,各个 agent 调用同一个不更新的模型。近期的工作开始用 RL 直接训练:把整个多智能体流程看作一次 rollout,以任务的最终结果(答案是否正确、游戏胜负)作为奖励,沿用单智能体 LLM RL 的 PPO 或 GRPO 框架更新参数。被训练的对象因工作而异:Kimi K2.5 只训练 orchestrator,sub-agent 冻结;MAGRPO 和 MAPoRL 联合训练所有 agent;SPIRAL 让同一个模型扮演所有角色自我对弈。
这种做法直接继承了单智能体 RL 的训练流程(第 2 节)。区别在于,单智能体的一条轨迹只有一个决策者,多智能体的一条轨迹里有多个决策者的输出,奖励却仍然只有一个。如何把这个奖励分给各个 agent 和各个步骤,是本文讨论的信用分配问题(第 3 节)。
2LLM RL 的训练流程
以 GRPO 为代表的 LLM RL,一个训练步包含以下六步。对一道题 q 采样 G 条轨迹作为一个组;每条轨迹由模型输出 a 和环境或工具的返回 o 交替组成;verifier、judge 或环境给出奖励 r;把奖励累加成回报 R;用组内均值和标准差做 baseline 得到 advantage A;最后把 A 广播给这条轨迹的每个 token,做 clipped policy gradient 更新。
3问题是什么
图 2 用一个例子说明多智能体下第 ⑤ 步的问题。
合作型多智能体任务里,环境通常只给整个团队一个回报 \(R\)。每个 agent 要用这个标量更新自己的策略,需要回答两个问题:
谁的功劳
任务成功了,是哪个 agent 的贡献?失败了,是谁的错?
哪一步的功劳
一个 agent 走了很多步,哪些动作是好的?这是单智能体里就有的时间信用问题。
如果把 \(R\) 原样发给每个 agent,会出现两个经典症状:
- 噪声大:agent i 的梯度里混进了其他所有 agent 的随机性,团队越大,信噪比越低。
- 搭便车(lazy agent):有的 agent 学会了,其他 agent 就不再学,因为团队奖励已经够高。VDN 把它称为 “lazy agent” 问题,并指出它源于部分可观测。
LLM 多智能体让问题更难。 agent 常常是动态创建的,没有固定角色;轨迹很长,团队奖励被摊薄到大量 token 上;主流算法是不带 critic 的 GRPO,baseline 只能来自样本之间的比较;每条 rollout 都很贵,反事实重跑的成本很高。
4经典 MARL 的五种答案
这些方法都建立在 actor-critic 或 Q-learning 上,靠集中式的价值函数做信用分配。训练时集中、执行时分散(CTDE)是共同框架。点工作名打开原文。
Wonderful Life Utility(difference reward)
Wolpert & Tumer · Advances in Complex Systems 4(2–3), 2001agent η 的奖励等于团队实际得分,减去把 η 的分量“钳位”成固定值 CL 之后的得分。钳位成 0 等于把这个 agent 从系统里拿掉。后来文献通称 difference reward。
“WLU overcomes much of the signal-to-noise problem of team game utilities.” p.2 §1;定义见式 (7)
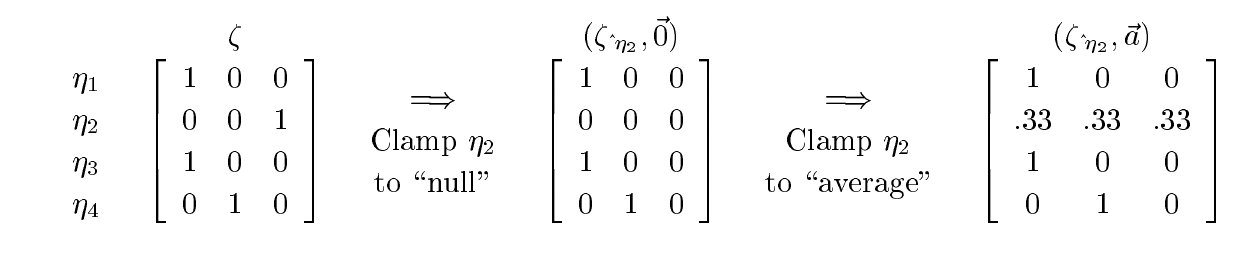
COMA
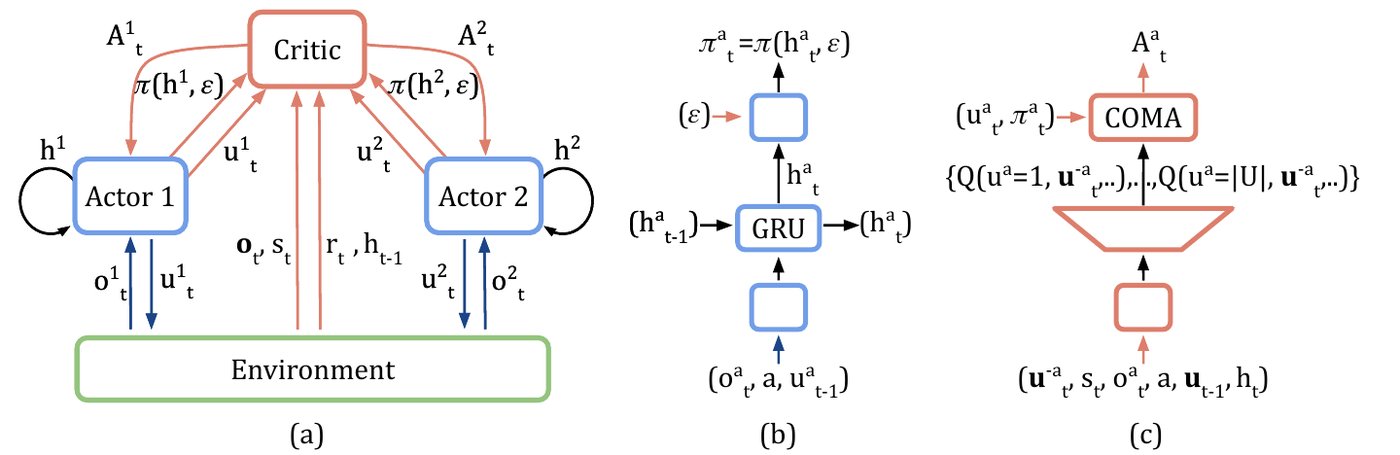
Foerster et al. · AAAI 2018用集中式 critic 代替重跑环境:固定其他 agent 的动作,只把 i 的动作边缘化掉,得到反事实 baseline。可以看作 difference reward 的可学习版本。
“it uses a counterfactual baseline that marginalises out a single agent's action” 摘要
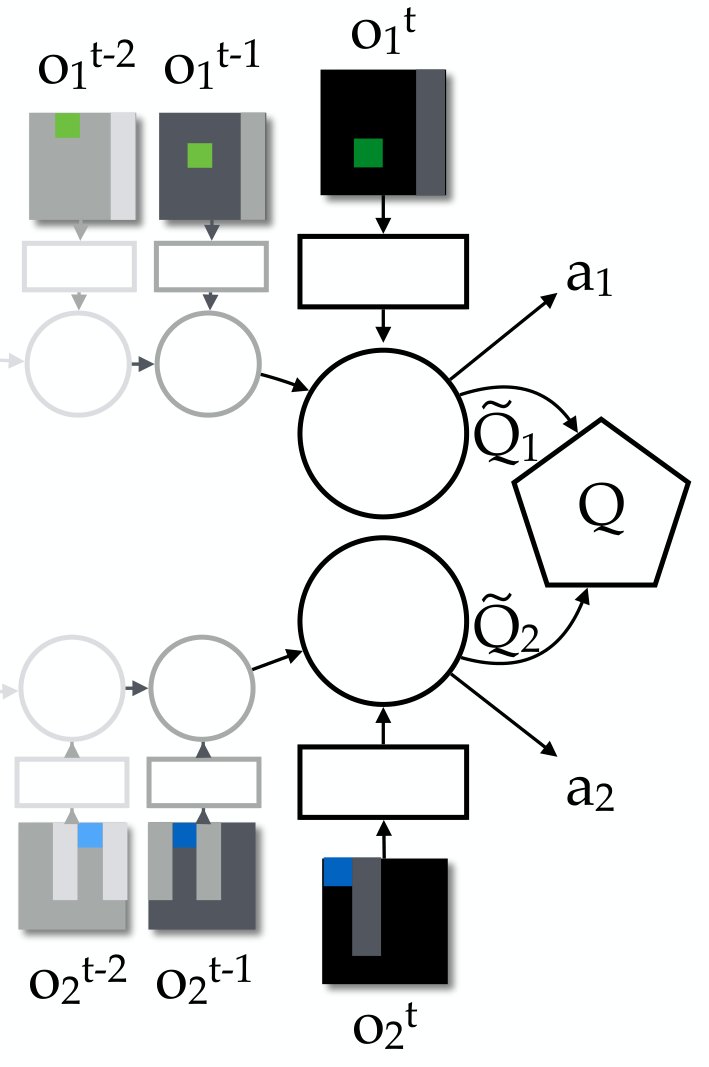
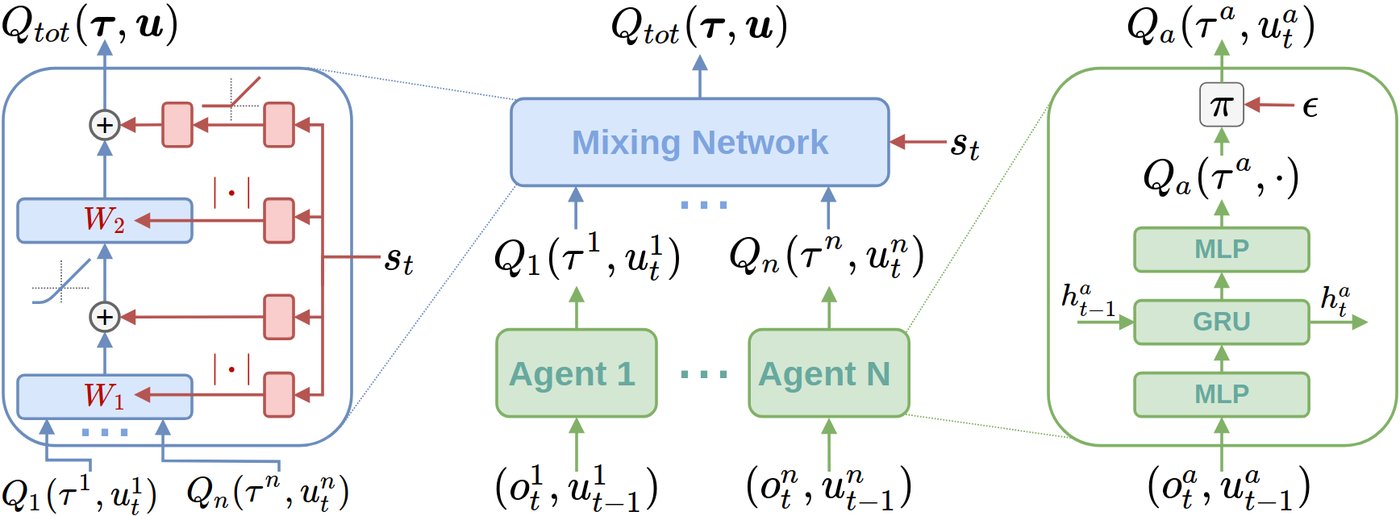
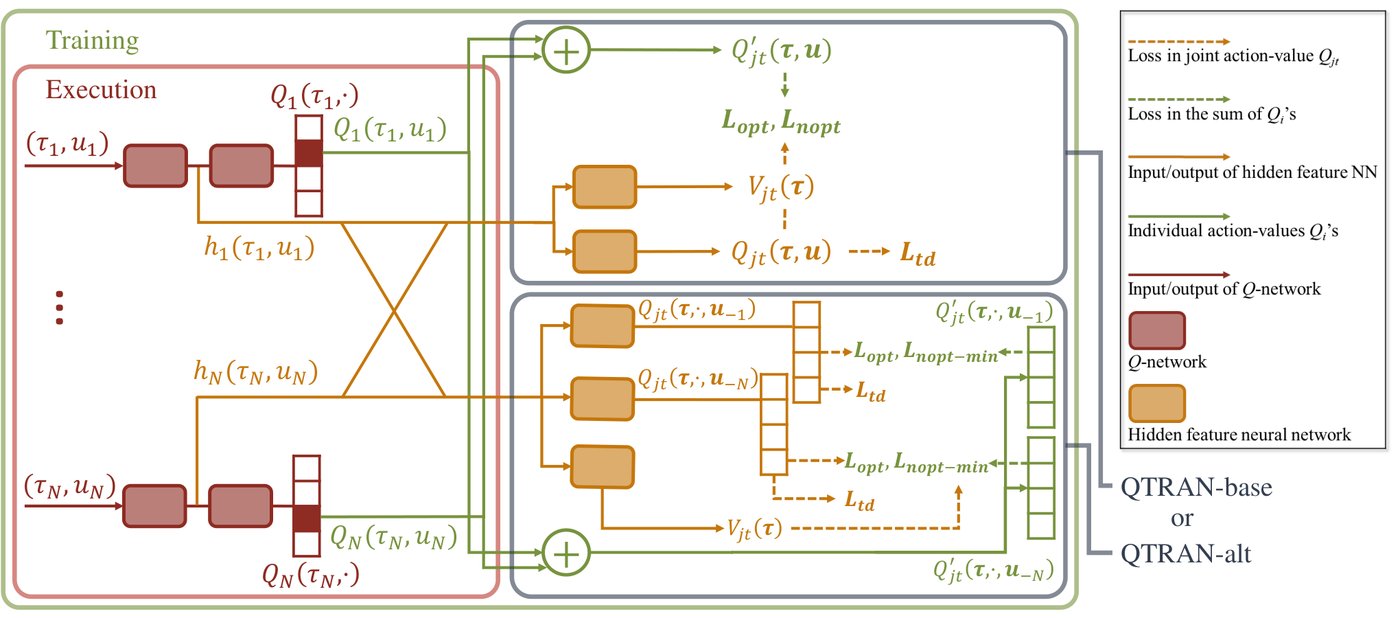
价值分解:把团队 Q 拆成每个 agent 的 Q,分解结构本身就隐含了信用分配。VDN 用求和,QMIX 用单调的 mixing 网络,QTRAN 去掉了这两种结构约束。
VDN:“learns to decompose the team value function into agent-wise value functions” · QMIX:“structurally enforce that the joint-action value is monotonic in the per-agent values” · QTRAN:“free from such structural constraints” 均为摘要
Shapley Q-value(SQDDPG)
Wang, Zhang, Kim, Gu · AAAI 2020用 Shapley 值把全局奖励分给每个 agent:对所有联盟取边际贡献的平均,满足公平性公理。精确计算要枚举指数多个联盟。
“Shapley Q-value is able to distribute the global reward, reflecting each agent's own contribution” 摘要
MAPPO:不显式分配
Yu et al. · NeurIPS 2022 Datasets & Benchmarks团队奖励加集中式 \(V(s)\),不做显式的信用分解,在 SMAC、Google Research Football、Hanabi 等基准上和 off-policy 的价值分解方法相当甚至更好。说明 agent 同质、能共享参数时,显式分配并不总是必要的。
“PPO often achieves competitive or superior results in both final returns and sample efficiency.” 摘要
5LLM 多智能体训练里的六类做法
LLM 时代的主要变化是去掉了 critic。GRPO 系方法的 baseline 来自一组样本的均值,所以信用分配的问题变成了拿谁和谁比。以下按比较对象分类。
A. 不分配:只训 orchestrator
Kimi K2.5 Agent Swarm(PARL)
Kimi Team · arXiv 2602.02276, 2026可训练的 orchestrator 加冻结的子 agent,子 agent 的轨迹不进入优化目标,被当作环境观测。奖励由三项加权:实例化奖励 \(r_{\text{parallel}}\) 防止退化成串行执行(serial collapse),子任务完成率 \(r_{\text{finish}}\) 防止只创建不完成的“虚假并行”,任务结果 \(r_{\text{perf}}\);前两项的权重在训练中退火到 0。子 agent 这一层的信用问题被直接绕开。
“sub-agents are frozen and their execution trajectories are excluded from the optimization objective” §1
B. 广播团队奖励,组内比较整局
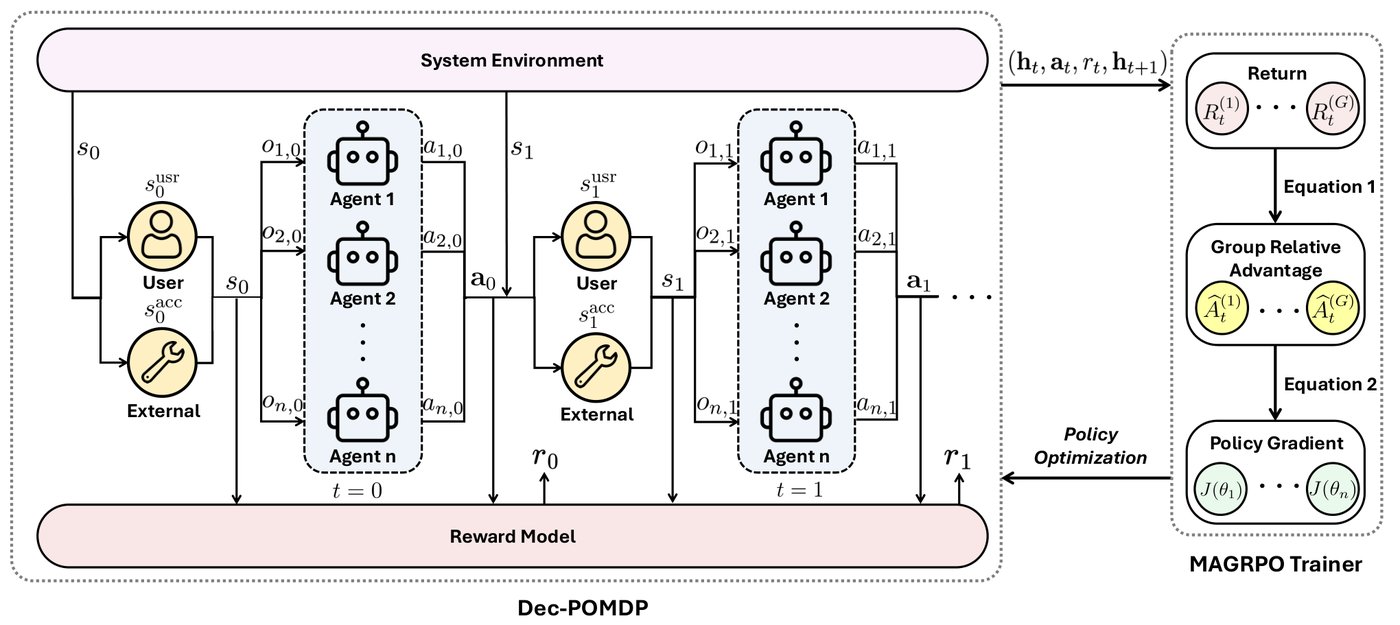
把 LLM 协作建模为 Dec-POMDP。所有 agent 共享一个联合奖励;每个 agent 每轮采样一组回答,baseline 是这组联合回报的均值;训练时集中,执行时各自独立。相当于 MAPPO 的 GRPO 版。写作和编程协作任务。
“Using a joint reward allows agents to specialize as needed to complete the task without complex prompt or reward engineering.” §3.1
MAPoRL
Park, Han, Guo, Ozdaglar, Zhang, Kim · ACL 2025多个 LLM 先各自作答,再多轮讨论修正,联合训练。verifier 同时评价答案和讨论过程,并额外奖励纠错和有说服力的发言,这个分数就是联合训练的奖励。
“a MAPoRL verifier evaluates both the answer and the discussion … The score serves as the co-training reward” 摘要
C. 按角色设 baseline
SPIRAL
Liu, Guertler, Yu, … Jaques · arXiv 2506.24119, 2025同一个模型在零和游戏里自博弈。RAE 为每个“游戏 × 角色”维护一个 baseline,用 EMA 更新(衰减率 0.95),因为先手和后手的期望回报本来就不同。
“RAE maintains separate baselines bG,p for each game G∈𝒢 and role p∈{0,1}.” §3
MARSHAL
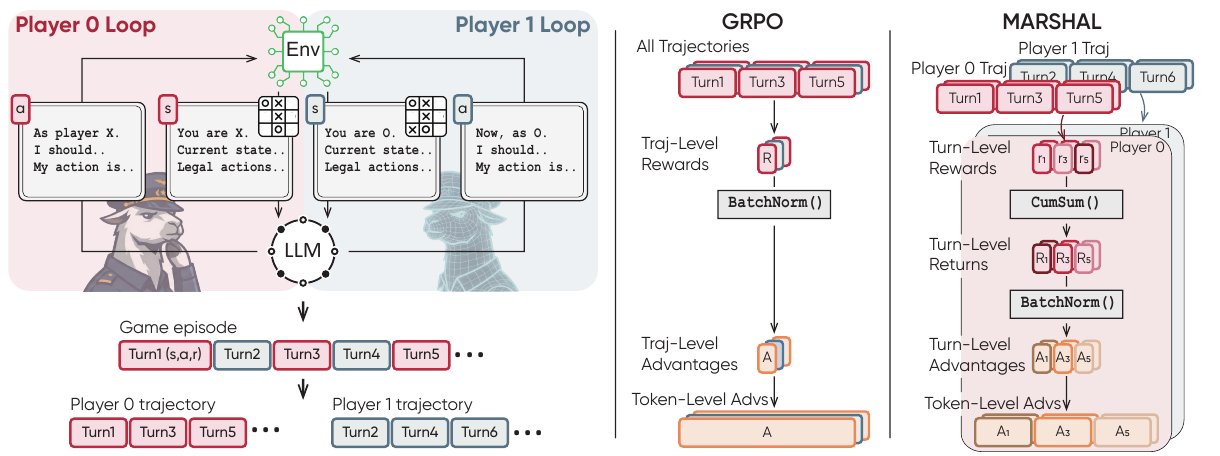
Yuan, Xu, … Yu, Wang · ICLR 2026合作和竞争游戏都做。先把每轮之后的奖励求和,再减同角色子组 \(p\) 的均值(sum-then-normalize)。消融里把它换成 RAE,Mini Hanabi 从 54.33% 掉到 24.93%,合作游戏受影响最大。前提是角色固定、每个角色在 batch 里样本够多。
“We partition the batch of trajectories into sub-groups based on player role and apply the turn-level advantage estimator described above independently within each sub-group” p.4 §3.2
D. 反事实:换掉一个再跑
C3
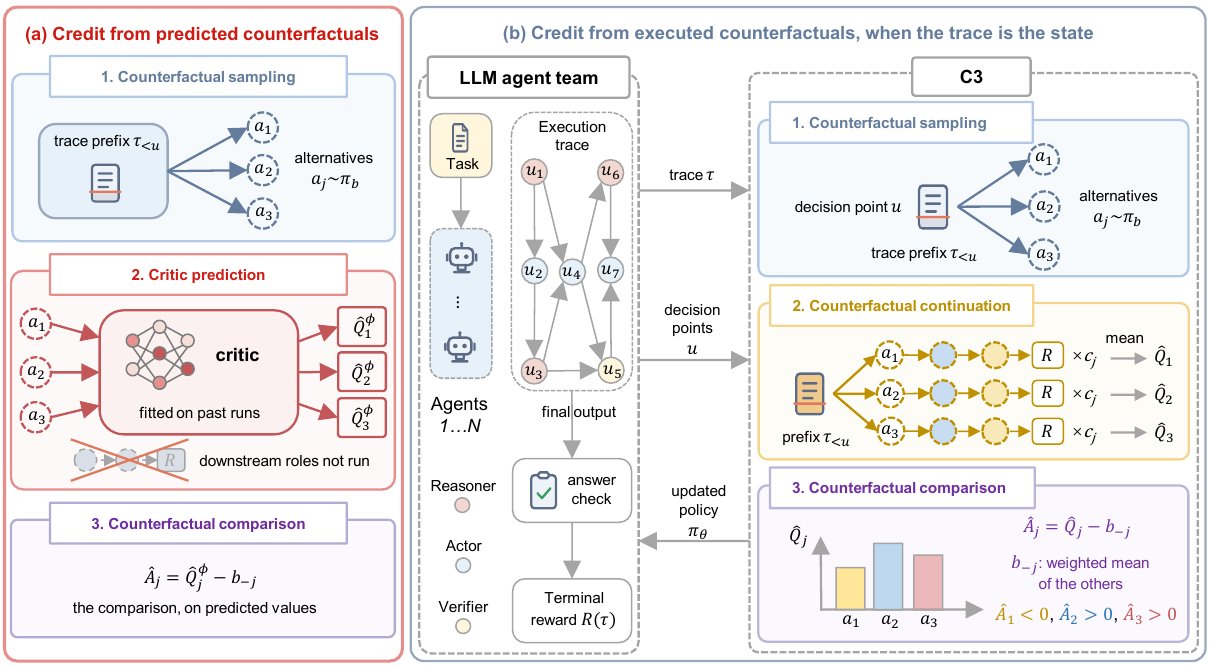
Chen et al. · arXiv 2603.06859, 2026消息级信用。在某个决策点把一条消息换成另一条,把后续流程一直跑到终局奖励,得到这条消息的无偏信用;只需重新生成决策点下游的消息。前提是下游 agent 读到的一切都写在记录里,这样记录本身就是状态,反事实可以真的执行。当前版本标题为 The Trace Is the State: Exact Credit Assignment for LLM Agent Teams。
“substitutes one message at a decision point and continues the run to the terminal reward, so its credit is unbiased, exact up to Monte Carlo error” 摘要
CCPO
Li, Tian, Chen, Zhang, Liu, Ban, Zhuang · arXiv 2603.21563, 2026agent 级信用。比较实际联合结果和去掉某个 agent 后的结果,得到每个角色的奖励,再交给 GRPO、GSPO 或 REINFORCE++。在 Think–Solve 双 agent 的数学推理上实验:去掉 Thinker 就是让 Solver 直接答题,额外采样 solver-only 的 rollout 并用 verifier 打分;Solver 没有对应的反事实,因为去掉它就没有答案了。
“estimates an agent's marginal contribution by comparing the realized joint outcome with a counterfactual outcome” 摘要
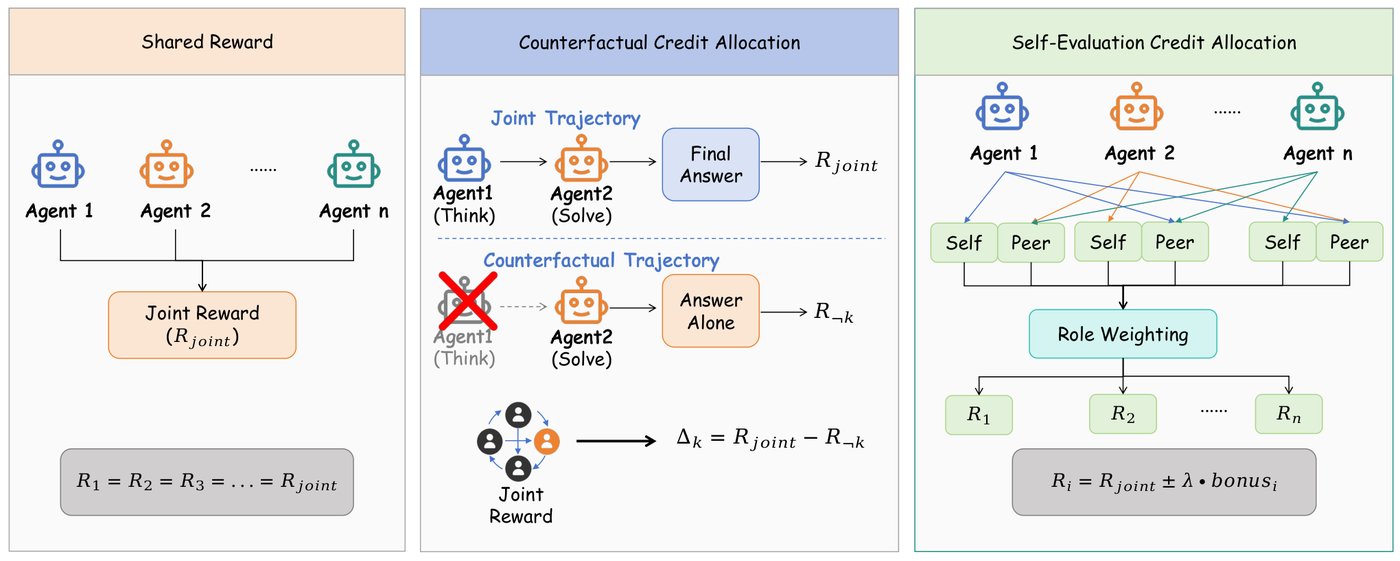
E. 在语言空间里分配
LangMARL
Yao, Da, Liu, Fleming, Chen, Wei · EMNLP 2026把合作 MARL 的信用分配搬到语言空间:从回放的轨迹里抽取和任务相关的因果关系,给每个 agent 稠密的文字反馈,用来改进各自的策略。适合奖励稀疏的场景。
“agent-level language credit assignment” 摘要
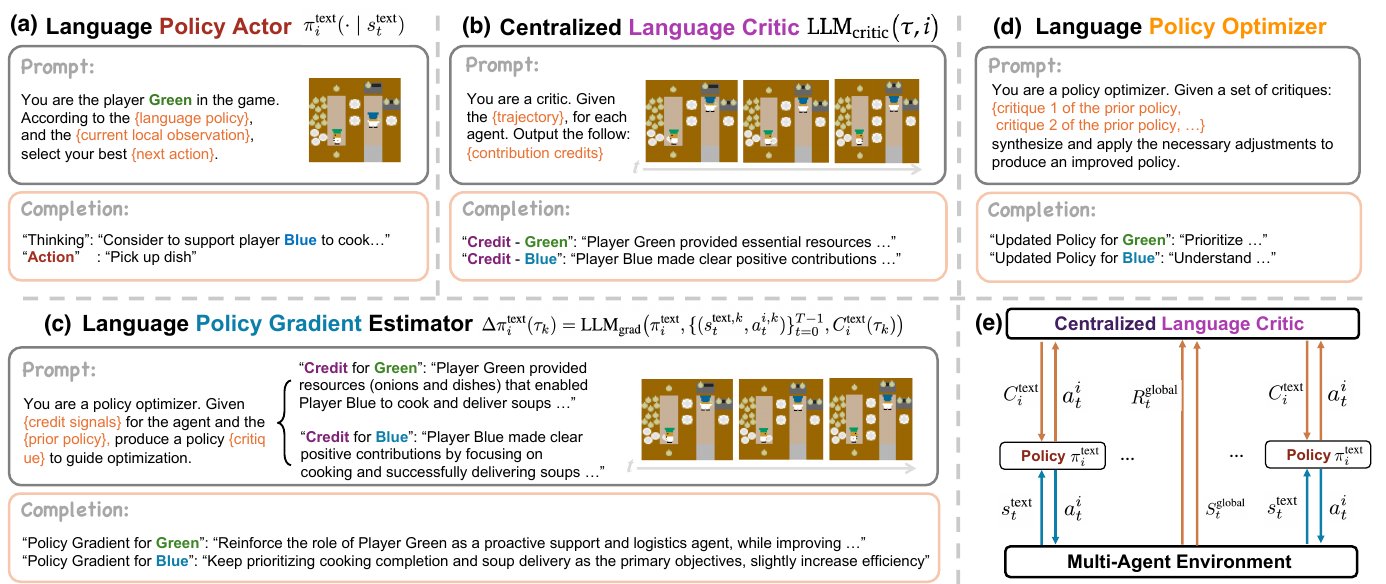
F. agent 内部的时间信用(单智能体工作,供参照)
MT-GRPO
Wei, Zeng, Li, … Hong · arXiv 2505.11821, 2025多轮 agent 里利用逐轮的稠密奖励做信用分配,分别推导了 GRPO 和 PPO 的版本,比较终局、延迟、逐轮三种奖励粒度。原题 Reinforcing Multi-Turn Reasoning in LLM Agents via Fine-Grained Reward Structure and Credit Assignment。
“dense per-turn reward structures consistently outperform sparse terminal and delayed reward structures” 摘要
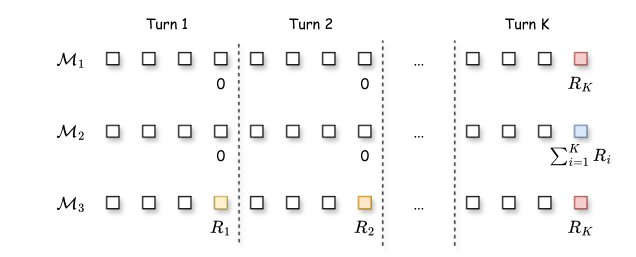
GiGPO
Feng, Xue, Liu, An · NeurIPS 2025在同一任务的多条轨迹里找到相同的状态作为锚点,在锚点上做 step 级组内比较。不需要辅助模型,也不需要额外 rollout。
“Actions stemming from the same state are grouped together, enabling micro relative advantage estimation.” 摘要
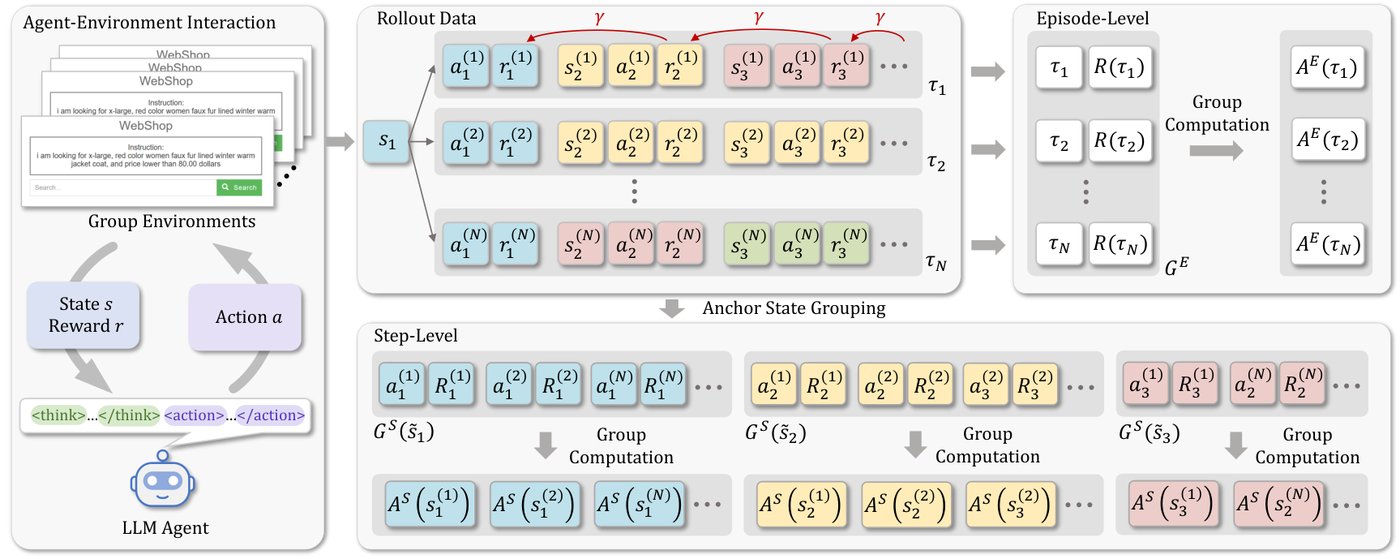
一篇值得读的综述:Reinforcement Learning for LLM-based Multi-Agent Systems through Orchestration Traces(Zhang,arXiv 2605.02801,2026.05)。它把一次多智能体 rollout 记成一张编排事件图:节点是六类事件,即 orchestrator 决策、派生 sub-agent、agent 间消息、工具调用、摘要返回和汇总;边是事件之间的时间或因果依赖(定义 3)。奖励和信用信号按从 token 到整个团队的 8 个单位归类。
“a set of events—orchestrator decisions, sub-agent spawns, inter-agent messages, tool calls, summary returns, and aggregation steps” §3.2 定义 3
其中两个观察与本文直接相关:
“explicit counterfactual message-level credit remains especially sparse in our curated pool” · “found no explicit RL training method for the stopping decision” 摘要
编排事件图上的信用单位
将以上工作置于同一张编排事件图上,它们的差别在于信用挂在图的哪个子结构上。
6对照:每种做法拿谁和谁比
| 做法 | 比较对象(baseline 来源) | 经典对应 | 额外成本 | 前提 |
|---|---|---|---|---|
| 只训 orchestrator | 同一 prompt 的其他整局 | — | 无 | 子 agent 能力够用 |
| 广播团队奖励 | 同一 prompt 的其他整局 | MAPPO | 无 | agent 同质,或不在乎区分 |
| 按角色设 baseline | batch 里同角色的其他轨迹 | 按角色的 critic | 无 | 角色固定,每类样本够多 |
| 反事实回放 | 同一上下文下换掉这个 agent 或这条消息 | COMA、difference reward | 每个 agent 或消息都要重跑 | 环境可以 fork 和重放 |
| 语言信用 | 不做数值比较,LLM 读轨迹归因 | — | 每局一次归因调用 | 归因模型可靠 |
| 状态锚点 | 其他轨迹里的相同状态 | 状态价值 \(V(s)\) | 无 | 状态会重复出现 |
7未来方向
现有方法的 baseline 有两种来源:经典 MARL 用学到的 \(Q\) 或 \(V\);GRPO 类方法用同组样本的均值,信用分配的质量取决于比较组的构造方式,各种构造方式的成本和前提见第 6 节的表格。对编排式系统,以下问题尚未解决。
- 动态派生的 sub-agent 缺少可比样本。每个 sub-agent 的任务由 orchestrator 临时生成,不存在同角色的可比样本;整局比较会把 orchestrator 的拆分质量混入 sub-agent 的信号;逐个做反事实回放的成本过高。
- orchestrator 的决策缺少直接的训练信号。综述统计到的以 orchestrator 为信用单位的工作很少,也没有找到专门训练停止决策的 RL 方法。Kimi K2.5 依靠人工设计的并行与完成度辅助奖励,并在训练中把它们逐步退火到零。
- 消息级信用的成本。C3 的反事实回放能给出无偏的消息级信用,但每个候选消息都要重跑后续流程。能否用学到的价值模型或局部检查代替重跑,仍有待研究。
8参考
- Wolpert & Tumer. Optimal payoff functions for members of collectives. Advances in Complex Systems 4(2–3), 2001.
- Foerster et al. Counterfactual Multi-Agent Policy Gradients. AAAI 2018.
- Sunehag et al. Value-Decomposition Networks For Cooperative Multi-Agent Learning. AAMAS 2018 (extended abstract).
- Rashid et al. QMIX: Monotonic Value Function Factorisation for Deep MARL. ICML 2018.
- Son et al. QTRAN: Learning to Factorize with Transformation for Cooperative MARL. ICML 2019.
- Wang et al. Shapley Q-value: A Local Reward Approach to Solve Global Reward Games. AAAI 2020.
- Yu et al. The Surprising Effectiveness of PPO in Cooperative, Multi-Agent Games. NeurIPS 2022 D&B.
- Kimi Team. Kimi K2.5: Visual Agentic Intelligence. arXiv 2602.02276, 2026.
- Liu et al. LLM Collaboration with Multi-Agent Reinforcement Learning (MAGRPO). AAAI 2026.
- Park et al. MAPoRL: Multi-Agent Post-Co-Training for Collaborative LLMs with RL. ACL 2025.
- Liu et al. SPIRAL: Self-Play on Zero-Sum Games Incentivizes Reasoning via Multi-Agent Multi-Turn RL. arXiv 2506.24119, 2025.
- Yuan, Xu et al. MARSHAL: Incentivizing Multi-Agent Reasoning via Self-Play with Strategic LLMs. ICLR 2026.
- Chen et al. The Trace Is the State: Exact Credit Assignment for LLM Agent Teams (C3). arXiv 2603.06859, 2026.
- Li et al. Counterfactual Credit Policy Optimization for Multi-Agent Collaboration (CCPO). arXiv 2603.21563, 2026.
- Yao et al. LangMARL: Natural Language Multi-Agent Reinforcement Learning via Semantic Credit Assignment. EMNLP 2026.
- Wei, Zeng et al. Reinforcing Multi-Turn Reasoning in LLM Agents via Fine-Grained Reward Structure and Credit Assignment. arXiv 2505.11821, 2025.
- Feng et al. Group-in-Group Policy Optimization for LLM Agent Training (GiGPO). NeurIPS 2025.
- Zhang. Reinforcement Learning for LLM-based Multi-Agent Systems through Orchestration Traces. arXiv 2605.02801, 2026.
每条描述和引文都已对照原文(摘要或正文)核对,引文后标注出处位置。点击引文会在原文中定位并高亮这段话;两篇 PDF(Wolpert & Tumer、MARSHAL)只能跳到所在页。MARSHAL 读过正文和附录;Wolpert & Tumer 的式 (7) 来自原文 PDF。
No references found.
Comments